Python与简单网络爬虫的编写
电影来了 存档这个电影资源搜索网站火起来了,曾有一段时间因为太多人访问我的博客,访问量高于平常十多倍,Apache、PHP和MySQL这三个庞大的东西搭建的庞大的wordpress博客就直接挂掉了,直接挂掉了,挂掉了,了。。。
从上一篇博文的评论中看出似乎很多同学都比较关注爬虫的源代码。我也给大家回复,当时写的文件比较乱,爬虫文件也很多,没时间整理,所以就直接发技术博文来说一下我个人对爬虫的研究收获。所以嘛,也就注定了我这篇文章只能跟爬虫相关了。
我第一次接触爬虫这东西是在今年的5月份,当时写了一个博客搜索引擎,所用到的爬虫也挺智能的,起码比电影来了这个站用到的爬虫水平高多了!
当时的文章链接: 通过友情链接进行博客Feed的搜集,你的博客收录了吗
本来也答应了网友把博客种子搜集的那个爬虫代码也公开的,唉,可惜我一直在服务器上用screen和vim来写代码,后来不久那个VPS就出故障了,提供商也没有给我修好。所以现在那个博客搜索引擎已经没有了。。。永远的没有了。。。只有等待新的出现!
回到用Python写爬虫的话题。
Python一直是我主要使用的脚本语言,没有之一。Python的语言简洁灵活,标准库功能强大,平常可以用作计算器,文本编码转换,图片处理,批量下载,批量处理文本等。总之我很喜欢,也越用越上手,这么好用的一个工具,一般人我不告诉他。。。
因为其强大的字符串处理能力,以及urllib2,cookielib,re,threading这些模块的存在,用Python来写爬虫就简直易于反掌了。简单到什么程度呢。我当时跟某同学说,我写电影来了用到的几个爬虫以及数据整理的一堆零零散散的脚本代码行数总共不超过1000行,写电影来了这个网站也只有150来行代码。因为爬虫的代码在另外一台64位的黑苹果上,所以就不列出来,只列一下VPS上网站的代码,tornadoweb框架写的 🙂
[xiaoxia@307232 movie_site]$ wc -l *.py template/*
  156 msite.py
   92 template/base.html
   79 template/category.html
   94 template/id.html
   47 template/index.html
   77 template/search.html
下面直接show一下爬虫的编写流程。以下内容仅供交流学习使用,没有别的意思。
以某湾的最新视频下载资源为例,其网址是
http://某piratebay.se/browse/200
因为该网页里有大量广告,只贴一下正文部分内容:
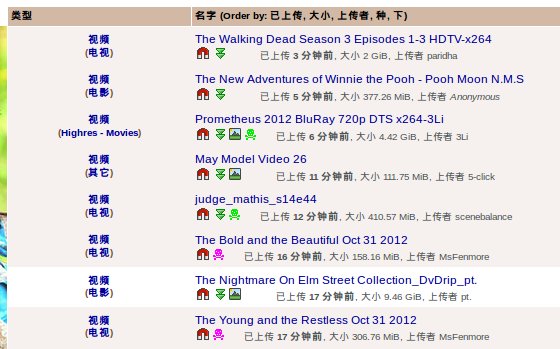
对于一个python爬虫,下载这个页面的源代码,一行代码足以。这里用到urllib2库。
>>> import urllib2
>>> html = urllib2.urlopen('http://某piratebay.se/browse/200').read()
>>> print 'size is', len(html)
size is 52977
当然,也可以用os模块里的system函数调用wget命令来下载网页内容,对于掌握了wget或者curl工具的同学是很方便的。
使用Firebug观察网页结构,可以知道正文部分html是一个table。每一个资源就是一个tr标签。

而对于每一个资源,需要提取的信息有:
1、视频分类
2、资源名称
3、资源链接
4、资源大小
5、上传时间
就这么多就够了,如果有需要,还可以增加。
首先提取一段tr标签里的代码来观察一下。
<tr><td class="vertTh">
<center>
<a href="/browse/200" title="此目录中更多">视频</a><br />(<a href="/browse/205" title="此目录中更多">电视</a>)</center>
</td>
<td>
<div class="detName"> <a href="/torrent/7782194/The_Walking_Dead_Season_3_Episodes_1-3_HDTV-x264" class="detLink" title="细节 The Walking Dead Season 3 Episodes 1-3 HDTV-x264">The Walking Dead Season 3 Episodes 1-3 HDTV-x264</a>
</div>
<a href="magnet:?xt=urn:btih:4f63d58e51c1a4a997c6f099b2b529bdbba72741&dn=The+Walking+Dead+Season+3+Episodes+1-3+HDTV-x264&tr=udp%3A%2F%2Ftracker.openbittorrent.com%3A80&tr=udp%3A%2F%2Ftracker.publicbt.com%3A80&tr=udp%3A%2F%2Ftracker.istole.it%3A6969&tr=udp%3A%2F%2Ftracker.ccc.de%3A80" title="Download this torrent using magnet"><img src="//static.某piratebay.se/img/icon-magnet.gif" alt="Magnet link" /></a> <a href="//torrents.某piratebay.se/7782194/The_Walking_Dead_Season_3_Episodes_1-3_HDTV-x264.7782194.TPB.torrent" title="下载种子"><img src="//static.某piratebay.se/img/dl.gif" class="dl" alt="下载" /></a><img src="//static.某piratebay.se/img/11x11p.png" /><img src="//static.某piratebay.se/img/11x11p.png" />
<font class="detDesc">已上传 <b>3 分钟前</b>, 大小 2 GiB, 上传者 <a class="detDesc" href="/user/paridha/" title="浏览 paridha">paridha</a></font>
</td>
<td align="right">0</td>
<td align="right">0</td>
</tr>
下面用正则表达式来提取html代码中的内容。对正则表达式不了解的同学,可以去 http://docs.python.org/2/library/re.html 了解一下。
为何要用正则表达式而不用其他一些解析HTML或者DOM树的工具是有原因的。我之前试过用BeautifulSoup3来提取内容,后来发觉速度实在是慢死了啊,一秒钟能够处理100个内容,已经是我电脑的极限了。。。而换了正则表达式,编译后处理内容,速度上直接把它秒杀了!
提取这么多内容,我的正则表达式要如何写呢?
根据我以往的经验,“.*?”或者“.+?”这个东西是很好使的。不过也要注意一些小问题,实际用到的时候就会知道 🙂
对于上面的tr标签代码,我首先需要让我的表达式匹配到的符号是
<tr>
表示内容的开始,当然也可以是别的,只要不要错过需要的内容即可。然后我要匹配的内容是下面这个,获取视频分类。
(<a href="/browse/205" title="此目录中更多">电视</a>)
接着我要匹配资源链接了,
<a href="..." class="detLink" title="...">...</a>再到其他资源信息,
font class="detDesc">已上传 <b>3 分钟前</b>, 大小 2 GiB, 上传者
最后匹配
copyright xiaoxia.org
</tr>大功告成!
当然,最后的匹配可以不需要在正则表达式里表示出来,只要开始位置定位正确了,后面获取信息的位置也就正确了。
对正则表达式比较了解的朋友,可能知道怎么写了。我Show一下我写的表达式处理过程,

就这么简单,结果出来了,自我感觉挺欢喜的。
当然,这样设计的爬虫是有针对性的,定向爬取某一个站点的内容。也没有任何一个爬虫不会对收集到的链接进行筛选。通常可以使用BFS(宽度优先搜索算法)来爬取一个网站的所有页面链接。
完整的Python爬虫代码,爬取某湾最新的10页视频资源:
# coding: utf8
import urllib2
import re
import pymongo

db = pymongo.Connection().test
url = 'http://某piratebay.se/browse/200/%d/3'
find_re = re.compile(r'<tr>.+?\(.+?">(.+?)</a>.+?class="detLink".+?">(.+?)</a>.+?<a href="(magnet:.+?)" .+?已上传 <b>(.+?)</b>, 大小 (.+?),', re.DOTALL)

# 定向爬去10页最新的视频资源
for i in range(0, 10):
    u = url % (i)
    # 下载数据
    html = urllib2.urlopen(u).read()
    # 找到资源信息
    for x in find_re.findall(html):
        values = dict(
            category = x[0],
            name = x[1],
            magnet = x[2],
            time = x[3],
            size = x[4]
        )
        # 保存到数据库
        db.priate.save(values)

print 'Done!'
以上代码仅供思路展示,实际运行使用到mongodb数据库,同时可能因为无法访问某湾网站而无法得到正常结果。
所以说,电影来了网站用到的爬虫不难写,难的是获得数据后如何整理获取有用信息。例如,如何匹配一个影片信息跟一个资源,如何在影片信息库和视频链接之间建立关联,这些都需要不断尝试各种方法,最后选出比较靠谱的。
曾有某同学发邮件想花钱也要得到我的爬虫的源代码。
要是我真的给了,我的爬虫就几百来行代码,一张A4纸,他不会说,坑爹啊!!!……
都说现在是信息爆炸的时代,所以比的还是谁的数据挖掘能力强 😀
110 条评论
想不到那么简单。不过数据库应该也是个问题
网站有时会防采集,频率过高会无法连接。
某湾不会 🙂
这个爬虫,可以离线爬么?
其实这个可以用openwrt路由器来爬的。。虽然数据处理会慢一点。。
那个,beautifulsoup 使用的是正则解析,所以绕了那么多弯的正则解析当然比你直接正则解析要慢很多啦。你可以试试 lxml + XPath,很强大的,比如我搜索 fluxbb 论坛上已更新的无回复新帖的 a 元素://*[@id="vf"]//*[@class="tc3" and text() = 0]/parent::tr/td[@class="tcl"]//a[not(@title)]
你好,我也学做python采集,按照你这个方法,能用一条xpath路径获取多个信息吗,例如采集一个小说页面,能否一次就提取标题、作者、点击数等,还是要分别写不同的Xpath路径分别获取,谢谢
一条 XPath 搞定一项吧。其实因为那些信息都是有相对关系的,所以一条 XPath 定位到那里之后再找其余的信息就会简单很多了。(lxml 的任何节点对象上都可以使用 XPath 查询的。)
尝试了一下,分开写的,个人觉得Xpath比正则表达式要好理解一些,但不知道在处理大数据时候效率哪个会高一些(因为我之前写的正则表达式虽然能获取到信息,但是效率很低明显还能优化)
lxml 就是为大数据处理而作。不过不清楚你说的大数据指的是单个巨大的 HTML 还是数量众多的小 HTML。对于前者可能 XPath 效率并不会太好。但只要不是故意找碴肯定比正则快。
单个文件,我目前改用XPath,html文件的代码结构比较复杂,我正则优化不到比较理想的状态,XPath也容易手上一点,谢谢你的推荐
个人觉得正则表达式可能会快些,而且能处理一些很复杂的情形,不过就是编写的时候不容易。
不好意思,请问一下 在第八行的 find_re = re.compile(r'.+?\(.+?">(.+?).+?class="detLink".+?">(.+?).+?<a href="(magnet:.+?)" .+?已上传 (.+?), 大小 (.+?),', re.DOTALL) 这句话能不能解释一下- - 谢谢啦, 初学python和爬虫,谢谢赐教。
这个是正则表达式。网上教程很多,有点长,不知道你哪部分有疑问。
每个网站一个爬虫规则,这个工作量会不会有点大?
这个主要是改正则表达式,只要写好一个,其他的都会很容易搞定的
这个爬虫是爬几个特定的大的视频网站?
原来也是用正则来提取内容,还用到了数据库,这个我得看下数据库咯
千言万语汇成一句话..
谢谢分享...
:)前来支持一下!
话说小虾有没有关注过 scrapy 感觉这个挺方便
前段时间研究过关于登录人人网抓取一些数据的东西,不过登录人人网现在貌似需要验证码了。这个没解决,在研究下吧。
用cookie 无压力
之前也小研究过Python爬虫
http://www.lovelucy.info/python-crawl-pages.html
求小虾是如何挖掘数据的......这才是最有技术含量的啊~
不坑爹,代码简单有效,如果代码囊肿,那才是坑爹
小虾,能翻译下这些文章供大家学习吗?讲数据结构和算法的,我感觉挺好的。但我英文不好,翻译来不好。
地址:http://eternallyconfuzzled.com/tuts/datastructures/jsw_tut_hashtable.aspx
蛮长的,不过翻译嘛,挺不错的想法!
我有空试试,先mark了 😀
希望能取得联系。关于DDWRT或者其他开源的路由器编写web登陆脚本。合作分成。
web登录脚本?很简单啊,怎么合作?
同样喜欢python,刚接触mongo。 丫的觉得python+mongo就是绝配,还没研究nginx+php + mysql 和 python+mongo做的站点那个性能和占用资源更加好点?刚弄了个廉价的vps 内存只有193
mongo在数据量大时需要内存比较充足的服务器,如果要读写磁盘,效率也不高。
推荐使用github哇 。。
这个建议很不错!!!
mongodb数据库有中文资料没,給提供一下,很感兴趣,,C#不知道能用这数据库不。
好像有,你可以搜一下!!!
http://www.cnblogs.com/fish-li/archive/2011/06/26/2090800.html
xiaoxia,你是用的什么VPS主机?我也准备弄个
大部分是burst的主机,我的paypal里有钱,所以支付很方便。有时也有一些国内或者香港的主机是准备放一些网站让国内的用户访问的。
paypal必须信用卡充值吗?
应该是吧……
请问xiaoxia用什么工具检查正则 是否正确
直接跑一下看效果就知道了 🙂
原来你也是用这种办法,我一直以为你有什么高级办法来着,然后,比较想知道的是,你怎样进行大批量的爬行,一个链接一个链接的进行深度检索?
是广度优先搜索 🙂
方法都比较简单,但是想法有不少。
hi, 想提个小建议:前后一篇博文的链接能不能放到页面顶端或者文章的最后?现在每次要翻都要一路跳过评论到页面最底端,觉得有点麻烦。 谢谢
Hi, 不知道wordpress这个东西怎么配置,可能要装插件。
没有接触过python,只学php。能简述一下两者的不同吗?thanks
变量不用$。。。
那应该和C一样了,C变量也不用$,哈哈
我很感兴趣的是存储,不知道博主如何解决的。如果数据非常大的时候,存储的速度是一个很大的瓶颈。我看你用到了mongodb,不知道具体是多大的数据量。
有些collections的条目数目有几十万啦~还未过百万条数据。速度上用索引优化一下,O(logN)是很可观的效率。
求私信个QQ什么,交流一下。哈哈。
同一部电影在不同站点上的名字可能不一样,你是肿麽做对应的,有什么高效的算法?感觉工程量很大
真的火了。一段时间没看 电影来了 这个网站,发现界面也变了。
我用requests请求某湾的页面,会连接失败,用proxy试了10s还是连不上,求教你是怎么连上,而且还能一直抓取,就是不知道你抓的效率怎么样~
# -*- coding: utf-8 -*-
import requests
proxies = {
"https": "203.122.26.124:8080",
"https": "110.138.240.218:8080"
}
headers ={'User-Agent': "Mozilla/5.0 (Windows NT 6.1; rv:17.0) Gecko/20100101 Firefox/17.0"}
url = 'http://thepiratebay.se/browse'
# url = 'http://www.baidu.com'
try:
req = requests.get(url, headers = headers, proxies = proxies,\
timeout = 10)
except requests.ConnectionError:
print 'ConnectionError'
我的爬虫放在国外的服务器呀
租的服务器不是不能挂爬虫么。。。
有这种说法???
楼主,是买的哪个服务器,方便说下吗
这个不得不来膜拜一下了。。
学习python来了 收藏电影FM~
我也比较喜欢Python的呢,可惜我学习的专业通常用的都是MATLab和C++,基本没人知道py,唉……前段时间用py写了一个程序帮一个实验室处理数据,还差点儿被鄙视了
请问站长,下载文件的“文件大小‘是怎么测算并显示出来的,可以给我指点一下吗,谢谢。
torrent info里有。
如果有些资源缺少“torrent info”这个文件,请问站长,又该如何?谢谢。
xiaoxiao,请问电影来了这个网站你放在什么服务器,感觉速度不错,可以推荐一下吗?
电影FM上那个迅雷云点播是怎么弄得?能放源码出来吗?
破解版迅雷云点播。
那个,我正在收集 DianYing.fm 的磁力链资源,想图个省事!谢谢小虾的付出~!特来打个招呼,表示感谢!
原来电影来了是你老兄写的呀?!
原来"re.DOTALL"的意思是"."可以match所有字符(包跨换行)。。。 被这个坑了,还以为是默认参数T_T
多谢小虾!就靠这篇文章入门爬虫啦~
如果网站禁止爬虫
如何伪造浏览器访问呢?
看禁止方式,对症下药。可以伪造UA或者Cookie
第一次用python写程序
写了简单的一个爬虫。
http://www.cnblogs.com/xibaohe/archive/2013/05/02/3055482.html
我想请教一下,有哪些方法取出重复的url
效率怎么样?谢谢
是去除
你是指去重么?
数量不多可以用set。数量非常庞大可以考虑布隆过滤器。
好吧,我就是用的 Set
多谢。
小虾看的是什么书啊,布隆过滤器还是第一次听啊。
bloomfilter,你去看wiki上的说明。。。
你好,有两个问题想要请教你一下
1、请问你电影来了一共爬了有多少个站点
2、关于数据去重是怎么做的
做资源整合,站点来源肯定不一。数据去重,有自己的匹配影片的算法能够满足。
xiaoxia大神,电影来了这个网站也是用python写的吗,用的什么框架呢
tornadoweb
我用的广搜 建议不要用urllib2 。会出现各种异常
我经常用urllib2就是为了异常,urllib不给异常不好维护。。。
可以试试 requests ,号称是给人用的——urlib2的替代版本
不习惯使用太多第三方的库,不过好用的话,会试一下
我是从谷歌搜索进来的,发现博主非常乐于分享并且对采集经验丰富,碰到些问题想请教下你:如果要釆集非常多的网站,采集规则怎么处理呢,如果每个都写的话那工程比程序还宠大了,有没有比较好的办法让程序自动分析网站分类,内容页正文,图片等。过年一直在思考这个问题,非常期待你的回复。新年快乐,祝电影FM马上流量多多!
用python即可。
如果需要人力判断,或者没有规则的事情,使用程序规则这个不好做的吧。
chongdata.com 是我写的一个网络爬虫~可以大规模提取网页关键字,现在免费试用,欢迎试用, 有凡客和淘宝的价格提取案例
表示感兴趣 😛
最近在学习python,找到了你的这个博客。
你在数据挖掘这方面很厉害啊,不知道有什么相关的书推荐没有。
我最近在做网站时遇到了些问题,希望请教下:该如何把我爬取到的图片文字等内容自动整合发布到我的网页上呢?就像你的电影FM一样,我在网上搜索了半天也没有找到明确的教程。我现在只能实现把文字的信息自动发布到wordpress网站上去。
ps:希望你的博客能多一些更新。
我用Mongodb和python。
python好高端的样子,看了一下午的DHT网络也只是简单的了解了一点点原理,感觉要用c++写出来的话没点头绪 = =
上面的哦代码不能运行,find_re的部分好像有括号没有闭合
在学生时代就能写出这么有用的东西,不简单啊!加油哦,看好你!看来我的网站要想做好,也要学学python才行了。我的临时存放点http://www.guanlianan.com/search.aspx
以后放在www.itfar.com
不知道python这边有没有类似ruby里面nokogiri的库,可以像用jQuery一样获取网页的特定信息
这个站点就是用nokogiri抓到的东西
http://wuliaotu.aws.af.cm/boring_images
折腾了几天python爬虫,总感觉力不从心,然后还是用PHP来解决了
php不是很适合写爬虫吧?可能你不是很熟练,继续加油。
您好,我需要一个类似的从招聘网站爬招聘信息的功能,每天跑,文本。多少钱?
你好,本人不做短期项目。
小虾大神,怎么让爬虫变成多进程的?能不能介绍一下,网上关于多进程的教程都看不懂。。。
可以使用threading库。如果要协作,你可能还需要用到Queue。网上有很多例子。
刚接触python,现在让我写scrapy,要买个VPS,具体是什么??又没有推荐的
你可以先试试linode低配的,发现满足不了需求,再升级。
zha Simpo 连版权都被你去了
不会这种语言。。。
有幸看到楼主这篇文章啊,正好楼主的举例和我遇到问题一样。现在某湾的网站变成了https协议。
我在用urllib请求的是报下面的错误
urllib2.URLError:
google 半天都没解决。
网上有人说是OSX把sslv3关闭了,但是为啥别的https的网站没问题。比如baidu,github等等的。我用浏览器访问的时候发现这几个网站都是用1.2的版本实在想不出,这个 湾 的网站到底特别在什么地方,希望帮忙解答一下,不胜感激~~
引用本文的文章